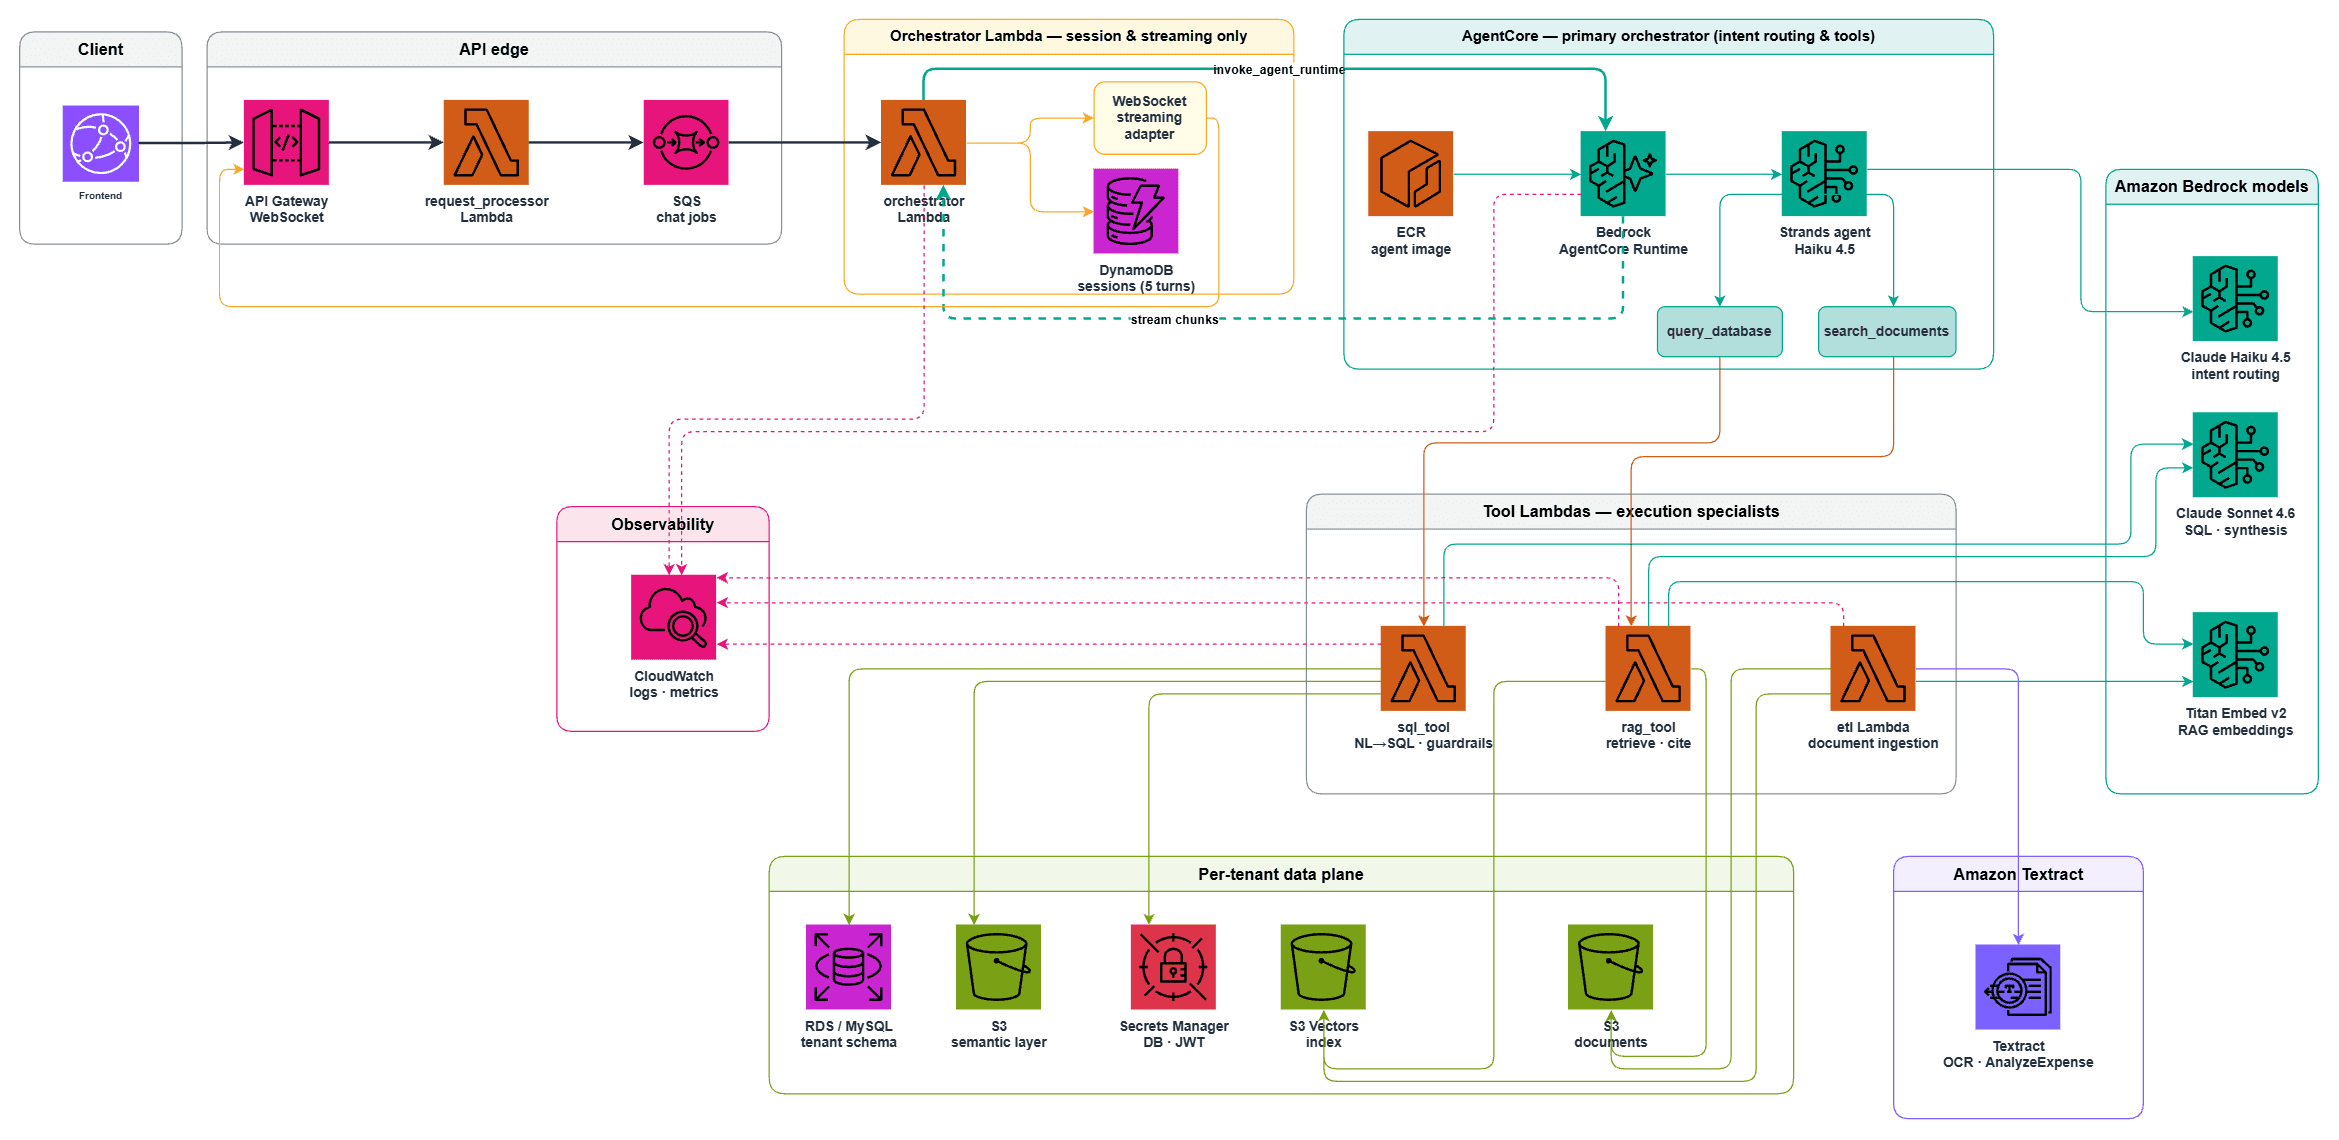
Vytvořili jsme event-driven AI engine na AWS, který směruje uživatelské dotazy buď na SQL databázové dotazy, RAG vyhledávání v dokumentech, nebo na hybridní cestu kombinující obojí.
Základní architektura a technologický stack
- Multi-model nastavení Amazon Bedrock: Model Claude Haiku 4.5 klasifikuje záměr uživatele (SQL, RAG nebo hybridní). Pro generování Text-to-SQL, formátování dotazů a syntézu odpovědí engine využívá Claude Sonnet 4.6. Embeddingy jsou generovány pomocí Titan Embed Text v2.
- Asynchronní API Gateway a SQS: WebSocket API přijímá dotazy klienta a okamžitě ukládá ID úloh do fronty Amazon SQS, přičemž vrací HTTP 202. Orchestrační AWS Lambda následně úlohu zpracuje a streamuje tokeny zpět přes WebSocket.
- Automatizovaný ETL a Textract pipeline: Nahrané dokumenty v S3 spouštějí Lambda pipeline. Standardní textová PDF jsou parsována nativně, zatímco skenované soubory procházejí přes Amazon Textract. Faktury s určeným prefixem spouštějí Textract AnalyzeExpense pro extrakci metadat o dodavateli a textu z loga.
- Sémantická vrstva: Definice schématu ve formátu YAML uložená v S3 mapuje databázové entity, joiny, obchodní terminologii a ukázkové SQL páry, čímž navádí LLM bez nutnosti strukturálních změn v databázi klienta.
- Observabilita a telemetrie: Bylo navrženo strukturované JSON logování a telemetrie sledování kroků agenta, které umožňuje inženýrskému týmu klienta bezpečně sledovat kroky uvažování LLM, generované SQL dotazy a latenci provádění přímo přes AWS CloudWatch.
Klíčová zjištění a optimalizace
Během vývoje mělo na výslednou architekturu významný vliv několik technických optimalizací:
- Efektivita směrování záměru: Přesunutí klasifikace dotazů na Claude Haiku snížilo latenci a spotřebu tokenů a ponechalo Claude Sonnet pro tvorbu SQL a generování odpovědí. Přepínač prostředí umožňuje spustit celou pipeline na Haiku, což snižuje náklady na model o 61 % při mírném poklesu skóre v oficiálním hodnocení (ze 70 % na 63 %).
- Cílená strategie Textract: Spouštění AnalyzeExpense (0,01 USD/stránka) pouze u určených prefixů faktur/pracovních příkazů — s návratem ke standardnímu OCR (0,0015 USD/stránka) nebo nativní extrakci textu jinde — zabránilo zbytečným nákladům na zpracování dokumentů.
- Předvídatelné modelování nákladů: Vytvořili jsme transparentní nákladový rámec založený na profilech aktivity uživatelů (nízká, střední, vysoká zátěž). Díky tomu mohl klient přesně odhadnout náklady na jeden dotaz napříč různými konfiguracemi modelů (Sonnet vs. Haiku) a oddělit proměnné náklady na LLM od fixních nákladů na infrastrukturu.